Agent Harness 评估指标
Agent 最后把任务做成了,不代表过程中没有反复纠正。这个项目记录首次交付、用户干预和失败恢复,尝试更具体地判断 AI 在真实任务里帮到了哪里。
评测项目 · 已有 35 个工作单元的初始基线 · 项目记录截至 2026-08-31
查看历史界面与产物
任务做完了,中间发生了什么
最后完成和第一次就合用,是两件不同的事。有人提醒后修好与 Agent 自己发现并修好,也意味着不同的使用成本。我把这些情况分别记下来,而不是只看一个完成率。
先说清什么算一条任务
以一个可独立判断是否完成的目标为单位。同一目标下的纠正、继续和返工合在一起,新目标才拆分。缺少证据的字段保留为 unknown,不当作零次干预;普通确认也不自动算纠正。
第一批记录
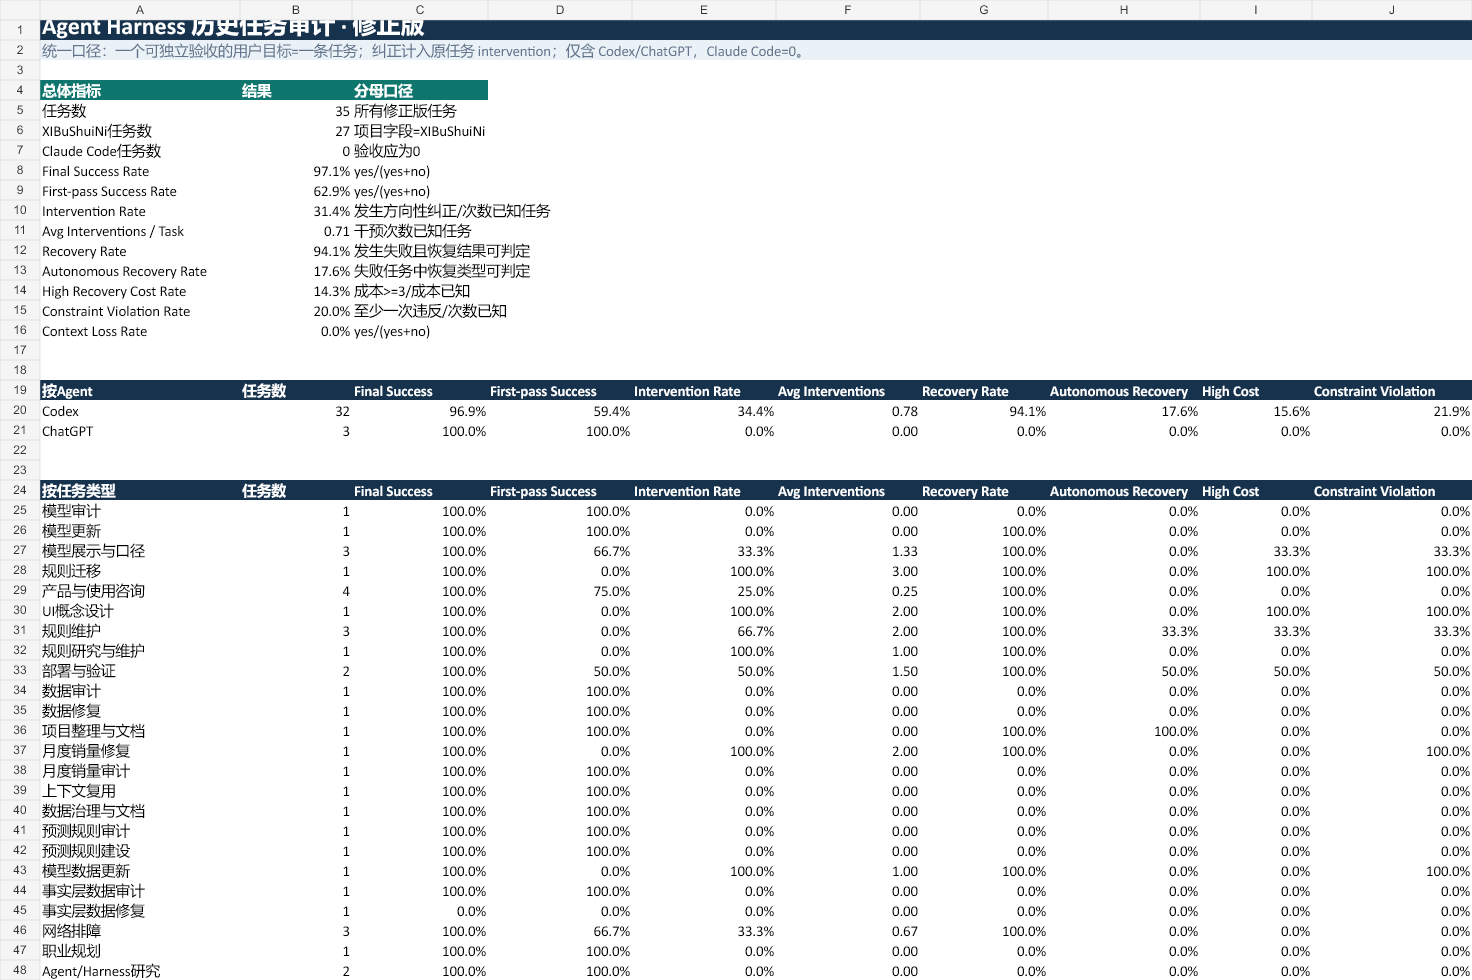
第一批整理了 35 个工作单元。其中 27 个来自西部水泥研究项目,工具构成为 Codex 32 个、ChatGPT 3 个,没有纳入 Claude Code。这更适合做个人使用的观察基线,还不足以比较工具的通用能力。
| 指标 | 结果 |
|---|---|
| 最终完成 | 34 / 35,97.1% |
| 首次完成 | 22 / 35,62.9% |
| 发生用户干预 | 11 / 35,31.4% |
完整指标口径
上表的分母为对应字段可判定的 35 个任务。平均干预次数为 25 / 35=0.71 次;失败恢复为 16 / 17=94.1%;自主恢复为 3 / 17=17.6%。后两项只计算发生失败、且恢复结果或恢复类型可判定的任务。
记录中另有 0—5 级恢复成本、约束违反和上下文丢失。缺少证据时保留 unknown,不用零替代。
接下来怎样积累
保持任务边界和判定方式一致,继续加入新任务,观察哪些场景需要更多纠正、哪些问题能够自行恢复。证据发生变化时再修订旧标签,并留下原因。
项目资料与记录日期
依据 ForHarness 2026-08-31 的指标定义、标签数据与汇总工作簿整理。工作簿保留任务明细、指标汇总、结论摘要和标签口径。这里只公开聚合结果,原始对话与任务明细保留在本地。